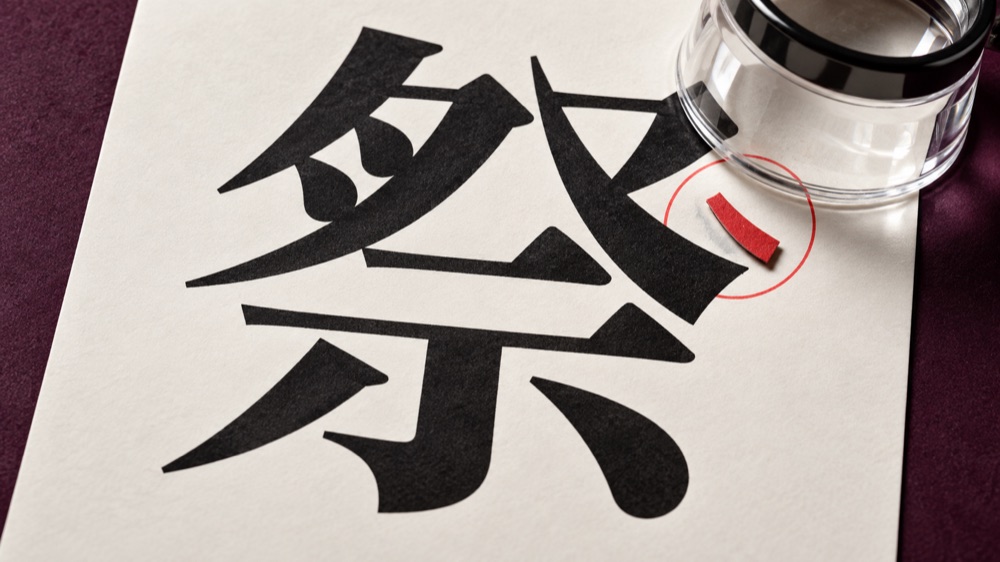
漢字検定(漢検)を運営する日本漢字能力検定協会の公式Xで、「祭」の字が間違っていました。
2026年10月18日、今年度2回目の検定の日に、協会は受検した人へ自己採点の結果を聞く投稿をしました。添えられていたのは「AIで生成」という表示の付いた画像です。その画像の中の「祭」の一部が、正しい形になっていませんでした。
投稿には、誤字を指摘する声が相次ぎました。ITmedia AI+の記事によると、「面白すぎる」という声に混じって、「どこよりも漢字を大切にしている協会が誤字を看過しているということが衝撃」という声もありました。協会は20日、同じ投稿への返信で「誤字があった」と謝罪します。そしてその後、「実際の検定で多く見られる『祭』の誤字4選」を紹介する投稿もしました。こちらには「肝座ってんなぁ」という反応が付いています。
笑い話で終わらせるには、もったいない出来事です。この件から考えたいことは二つあります。AIがなぜ見慣れた字の形を崩すのか。そして、会社の告知画像に文字を入れる工程を、どう組み立てればよいのか。どちらにも共通するのは、「祭」と読めることと、正しい「祭」が描かれていることは別だ、ということです。
「AIで生成」の表示は、正確さの保証ではない
先に、誤字を公開前に防ぐ側の話をします。
協会で、誰がどのように確認し、なぜ誤字が公開まで残ったのか。その経緯は、報道からは分かりません。なので、ここで協会の確認の仕方を論じることはしません。考えたいのは、どこの会社でも起こりうる一般的なことです。
一部だけ形の違う「祭」は、ぱっと見たときには「祭」と読めます。読めるから、意味は通る。意味が通れば、文章としては問題がないように見えます。キーボードで打った文章の誤字なら、変換ミスで別の字になるので、読み直せば引っかかることが多い。けれど、AIが描いた画像の誤字は、どの字でもない「祭らしき形」になることがあります。読み直しても、読めてしまう。
画像に付いていた「AIで生成」という表示から分かるのは、どうやって作ったかという情報です。文字や内容が正確かどうかを保証する表示ではありません。
つまずきは、読むところと描くところにある
では、AIはなぜ字の形を崩すのか。手がかりになるのが、Googleの研究者たちが2022年12月に発表した論文です。
画像を作るAIは、大きく二つの部分でできています。頼んだ文章を読み取る部分と、それをもとに画像を描く部分です。
まず、読み取る部分。当時の代表的な画像生成AI、Stable Diffusion、DALL·E 2、Imagenなどは、文章を一文字ずつ読んでいませんでした。よく出てくる文字の並びを、まとめて一つの単位として受け取ります。論文の図では、英語の「elephant」がまるごと一つの単位になっています。この方式では、単語がどの文字でできているかは、直接は与えられません。
学習を通じて、綴りをある程度は覚えられます。けれど、画像生成AIで使われていた規模では不十分でした。研究チームが、この方式の画像生成モデル(T5系)に、よく使う不規則動詞23語を描かせた実験では、「fought(戦った)」と描くはずのところを「fighted」と描くような、誤って「-ed」を付ける間違いが、生成した画像の11%に見られました。
研究チームは、文字を一つずつ読む部分を組み合わせたAIも作り、綴りの間違いを大きく減らしました。
ところが、それでも残った間違いがあります。字が抜ける。同じ字が二つ並ぶ。隣の字とくっつく。字の形が崩れる。これらは、文字を一つずつ読むAIにも、読まないAIにも、同じように出ました。論文は、画像を描く部分が、正しい字形を作って並べるのに苦労している「レイアウトの問題」(筆者訳)だと説明しています。作例では、Imagenが描いた「coffee」の「ff」の形が崩れていました。
つまり、何を書くべきかが分かっていても、その形を画像の中に正確に再現できるとは限らないのです。
漢字では、字形の複雑さも課題になる
中国のアリババの研究チームが2023年に発表した、さまざまな言語の文字を画像に描く技術の論文は、中国語の難しさについて、「画数の複雑さと、文字の種類の膨大さが大きな課題になる」(筆者訳)と書いています。英語の基本的な26文字と比べ、漢字は扱う字形がはるかに多く、一字ごとの線も多い。もちろん、生成の難しさは字形だけで決まるわけではなく、学習データやモデルの仕組みにも左右されます。同じ論文は、文字を一つずつ読む方式でも、中国語・日本語・韓国語の文字を描くのには苦労する、と先行研究を紹介しています。
この研究チームの工夫が面白いところです。描かせたい字を、決まったフォントで、置きたい位置に書いた画像を用意し、それを手がかりとしてAIに渡しました。綴りを伝えるだけでなく、字の見本を見せたわけです。
ここで、二つ断っておきます。一つは、紹介した研究は2022〜2024年のもので、現在の各サービスの性能をそのまま表すものではないことです。もう一つは、漢検の画像がどのAIで、どんな指示で作られたかは分からず、「祭」の誤りがどこで生じたのかは特定できないことです。言えるのは、2026年10月の時点でも、画像の中の漢字が崩れることは現にある、ということです。
秋祭りの告知で、AIに任せる絵、任せない文字
ここからは、架空の場面として、商店街の告知づくりを想定します。商店街の事務局で、秋祭りの告知画像を作ることになりました。提灯の並ぶ夜の通りの絵を、画像生成AIに頼みます。いい雰囲気の絵ができました。問題は、そこに入れる「秋祭り」「11月3日(火・祝)」「〇〇商店街振興組合」の文字です。
AIに文字ごと描かせることもできます。けれど、「秋祭り」と読めても、「祭」の線が一本違えば、正しい文字を載せたことにはなりません。日付の数字なら、人が集まる日を間違えて知らせることになります。
そこで、PIMOAのおすすめは、次の線引きです。
- 絵と文字を分ける。AIには背景やイラストだけを描かせ、店名・日付・値段・連絡先は、PowerPointやCanvaなどの編集ソフトで、フォントを使って後から入れる
- AIが描いた文字を残すなら、拡大して原稿と一字ずつ照合する。「読めるか」ではなく、画が欠けていないか、余分な線がないか、別の字になっていないかを見る
- 文字を後から入れた場合も、完成した画像で確かめる。打ち間違い、絵と重なって読みにくい、端で切れている、といった間違いはこちらでも起きる
一つ目で、字の形をAIに再現させる必要がなくなります。アリババの研究はAIに字の見本を渡して描かせる方法でしたが、こちらはもっと単純に、正しい字をそのまま画像の上に置く方法です。確認するのは、いつもの校正と同じ「書いた内容が正しいか」と「きれいに収まっているか」になります。
工程を変えても、うまくいかないところはある
後から文字を入れる方法が合わない画像もあります。看板の文字が曲面に沿っている、ネオンのように光っている、といった、文字が絵の一部になっている画像です。平らな文字を上に載せると、浮いて見えます。その場合は、AIに描かせ直すか、編集ソフトで文字を曲げたり光らせたりして合成することになります。
確認を機械に任せる方法も考えられます。画像の文字を読み取る仕組み(OCR)にかけて、原稿と比べるやり方です。ただ、読み取る側の判定も完全ではありません。Googleの論文でも、OCRで「間違い」と判定された画像を人が見直すと、実は正しく描けていたものが混じっていました。OCRは補助にとどめ、公開する文字は原稿と照合してください。
協会が謝罪のあとに紹介した「祭」の誤字4選は、検定でよく見られる、人の書き間違いの一覧でした。採点する側は、人がどこで間違えやすいかを知っています。けれど、自社の告知で先に決めておきたいのは、誰が誤字を見抜くかではありません。店名・日付・値段を、どの工程で、何を使って入れるかです。
PIMOAがおすすめするのは、告知の背景はAIで作り、店名・日付・値段はフォントで後から入れる工程です。「祭」の線が一本違わないかを毎回見抜く負担を、作る段階で減らせます。
参考文献・資料
「漢検運営が『AIで生成』画像で漢字ミス→謝罪 『これを出そうって神経が分からない』の声も」(ITmedia AI+、2026年10月22日)
Rosanne Liu ほか "Character-Aware Models Improve Visual Text Rendering"(Google Research、arXiv、2022年)
Yuxiang Tuo ほか "AnyText: Multilingual Visual Text Generation And Editing"(Alibaba Group、arXiv、2023年)