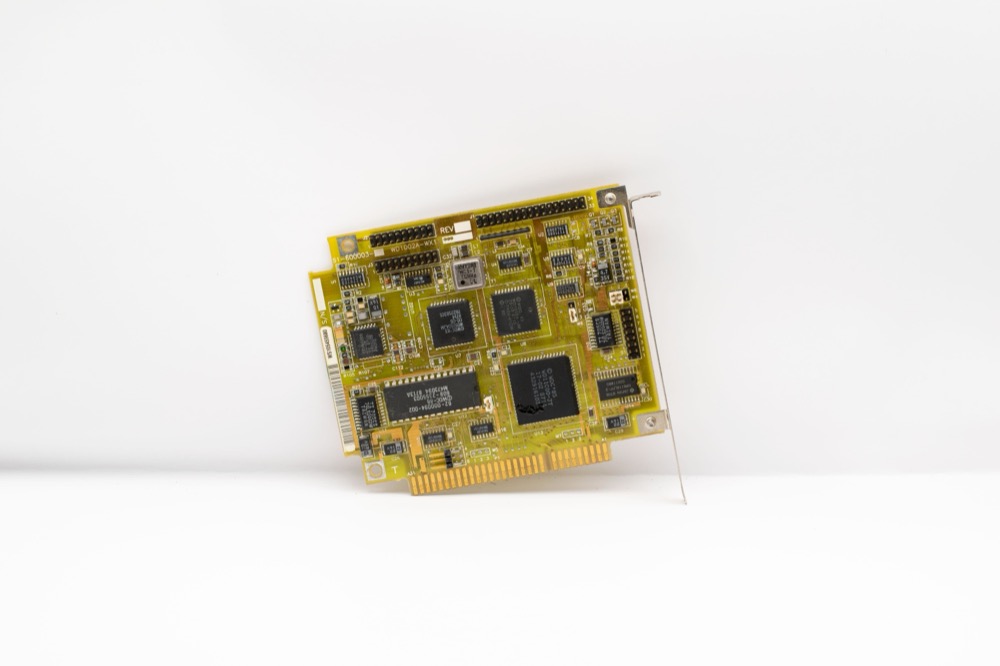
「AIで世界に遅れた日本」というイメージがあるかもしれません。しかし実は日本は1980年代、世界に先駆けて国家規模のAIプロジェクトを進めていました。それが「第五世代コンピュータ」プロジェクトです。今回は、この壮大な挑戦がどのように進み、何を教えてくれるのかを振り返ります。
第五世代コンピュータとは
第五世代コンピュータプロジェクトは、1982年に始まった日本の国家プロジェクトです。人間のように推論するコンピュータを目指し、国が主導し巨額の予算を投じて、約10年間にわたって研究・開発が行われました。
技術的には前進した。しかし「応用」との接続に失敗した
興味深いのは、このプロジェクトが技術的には確かな成果を上げていたという点です。専門家の間では「技術面では本当に成功した」という評価もあります。約11年間・総額540億円という国家予算を投じ、次のような具体的な成果物を生み出しました。
| 分野 | 具体的な成果物 |
|---|---|
| ハードウェア | 逐次推論マシン「PSI」、並列推論マシン「PIM」(1986年には三菱電機がPSIを製品化) |
| 基盤ソフトウェア | 並列論理プログラミング言語「KL1」、世界初の本格的な並列OS「PIMOS」 |
| 応用ソフトウェア | 並列データベース管理システム、並列定理証明器、自然言語インタフェース、法的推論システム、囲碁対局システム、LSI設計支援(CAD)ツールなど |
つまり、このプロジェクトは技術的に失敗したわけではありません。しかし、その技術を実際のビジネスや生活の中でどう活かすかという「応用」との接続に失敗し、一般市場向けの普及にはつながりませんでした。技術的な前進と、時代・市場に受け入れられることは、別の課題だったということです。
失敗の背景にあった構造的な問題
当時採用されていた「知識処理型」のAI(人間があらかじめ知識を整理してAIに教え込む方式)には、根本的な限界がありました。知識の収集や整理には膨大な労力がかかり、一度作ったシステムを新しい知識に合わせて更新することも簡単ではありませんでした。プロジェクトが力を注いだのは、あくまで「推論を高速に処理するための言語・マシン」という土台の部分であり、その上で実際に使われる「知識」や「応用ソフトウェア」を充実させる部分は手薄なままでした。当時から専門家の間でも「AI応用が進まないのは、推論マシンの性能不足ではなく、賢いAIソフトウェアの不足が原因だ」という指摘がありました。
さらに、プロジェクトが始まった1982年から終了する1992年にかけて、パソコンやワークステーションといった汎用コンピュータの性能が急速に向上し、価格も下がっていきました。専用に開発された高価な並列推論マシンは、この汎用コンピュータの進化スピードに追いつかれてしまい、産業界からの支持を十分に得られなかったことも、実用化に至らなかった一因とされています。加えて、当時のAI研究者自身が、実現には無理があると分かっていながら、予算を確保するために期待値の高い説明をしていた、という指摘もあります。
「失敗」がその後に落とした影
このプロジェクトが実用化に至らなかったことで、その後日本国内のAI研究への予算配分は大幅に削減され、多くの研究者が別の分野へと転向していったといわれています。一つの大規模プロジェクトの結果が、その国のAI研究の勢いそのものに、長期にわたって影響を及ぼした例だといえます。
40年前と現在、何が違うのか
第五世代コンピュータが目指したものと、今の生成AIを比べてみると、この40年で何が変わったのかが見えてきます。
| 第五世代コンピュータ | 現在の生成AI |
|---|---|
| 人間が知識を整理して与える | 大量のデータから学習する |
| 専用の推論マシン | 汎用的なクラウド・GPU |
| 応用範囲が限定的 | 多様な業務に利用可能 |
| 技術先行になりやすかった | 実際のサービスへの組み込みが進む |
| 実用化に課題 | ただし「使いこなし」が課題 |
技術の中身は大きく変わりましたが、最後の一行はそのまま今にも当てはまります。技術が使える状態になったことと、それを実際の業務に組み込めることは、今も別の課題だということです。
今の私たちが学べること
第五世代コンピュータが教えてくれるのは、「技術が優れていれば普及するわけではない」ということです。どれだけ高度な技術でも、誰が、どの業務で、どのように使うのかまで設計されていなければ、社会には定着しません。
これは現在の生成AIにも共通するテーマです。PIMOAでは、AIツールを導入することだけを目的にせず、「どの業務をどう変えるのか」まで整理した上で、現場への定着を支援しています。